Das Titelbild wurde KI generiert mit ChatGPT 5.6 Sol.
Datenschutzkonforme Transkription und KI-gestützte Zusammenfassung in einem System
Ein einstündiges Interview ist aufgenommen. Die Audiodatei wird in den Mittweida Scripter geladen und kurze Zeit später liegt die vollständige Transkription vor. Was früher mehrere Stunden manueller Arbeit erforderte, ist damit weitgehend automatisiert.
Doch dann beginnt häufig der nächste Arbeitsschritt.
Je nach Gesprächsdauer kann ein Transkript schnell viele Seiten umfassen. Wer beispielsweise ein längeres Interview, eine Gruppendiskussion oder ein aufgezeichnetes Meeting auswerten möchte, benötigt meistens nicht nur den vollständigen Wortlaut. Oft geht es zunächst darum, die wichtigsten Aussagen zu identifizieren, zentrale Themen herauszuarbeiten oder sich einen schnellen Überblick über das Gespräch zu verschaffen.
Eine Zusammenfassung ist deshalb häufig der logische nächste Schritt nach einer Transkription.
Und genau an dieser Stelle entstand für uns ein neues Problem.
Datenschutz endet nicht mit der Transkription
Bei der Entwicklung des Mittweida Scripters war eines unserer wichtigsten Ziele, Audio- und Videodateien innerhalb der Hochschulinfrastruktur verarbeiten zu können. Im Gegensatz zu vielen externen Diensten müssen sensible Interview- oder Gesprächsdaten damit nicht an kommerzielle Transkriptionsanbieter übertragen werden. Der Mittweida Scripter verarbeitet die Dateien auf Servern der Hochschule und löscht die hochgeladenen sowie erzeugten Dateien nach Abschluss der Verarbeitung wieder. Diese Grundidee stand bereits im Mittelpunkt der ersten Version des Tools.
Im Austausch mit den Nutzerinnen und Nutzern des Mittweida Scripters wurde uns allerdings immer wieder ein weiterer Bedarf deutlich: Zwar konnten Gespräche mit unserem Tool datenschutzkonform transkribiert werden, für die anschließende Auswertung und insbesondere für eine Zusammenfassung griffen einige Nutzerinnen und Nutzer jedoch wieder auf externe KI-Dienste zurück und übertrugen das erzeugte Transkript dorthin.
Der typische Arbeitsablauf könnte also ungefähr so aussehen:
Eine Person führt ein Interview mit möglicherweise sensiblen Inhalten. Die Aufnahme wird mit dem Mittweida Scripter innerhalb der Hochschulinfrastruktur transkribiert. Um diese schneller erfassen zu können, wird das Transkript in ein externes Large Language Model eingefügt und dort mit der Aufforderung versehen: „Fasse mir dieses Gespräch zusammen.“
Damit wäre zwar die ursprüngliche Audiodatei innerhalb unserer Infrastruktur geblieben – der daraus erzeugte Inhalt verlässt sie aber im nächsten Arbeitsschritt unter Umständen trotzdem wieder.
Für uns war deshalb relativ schnell klar: Wenn wir einen möglichst durchgängigen datenschutzkonformen Prozess anbieten möchten, darf dieser nicht mit der fertigen Transkription enden.
Transkribieren und zusammenfassen in einem Arbeitsschritt
Aus diesem Gedanken ist eine neue Funktion des Mittweida Scripters entstanden.
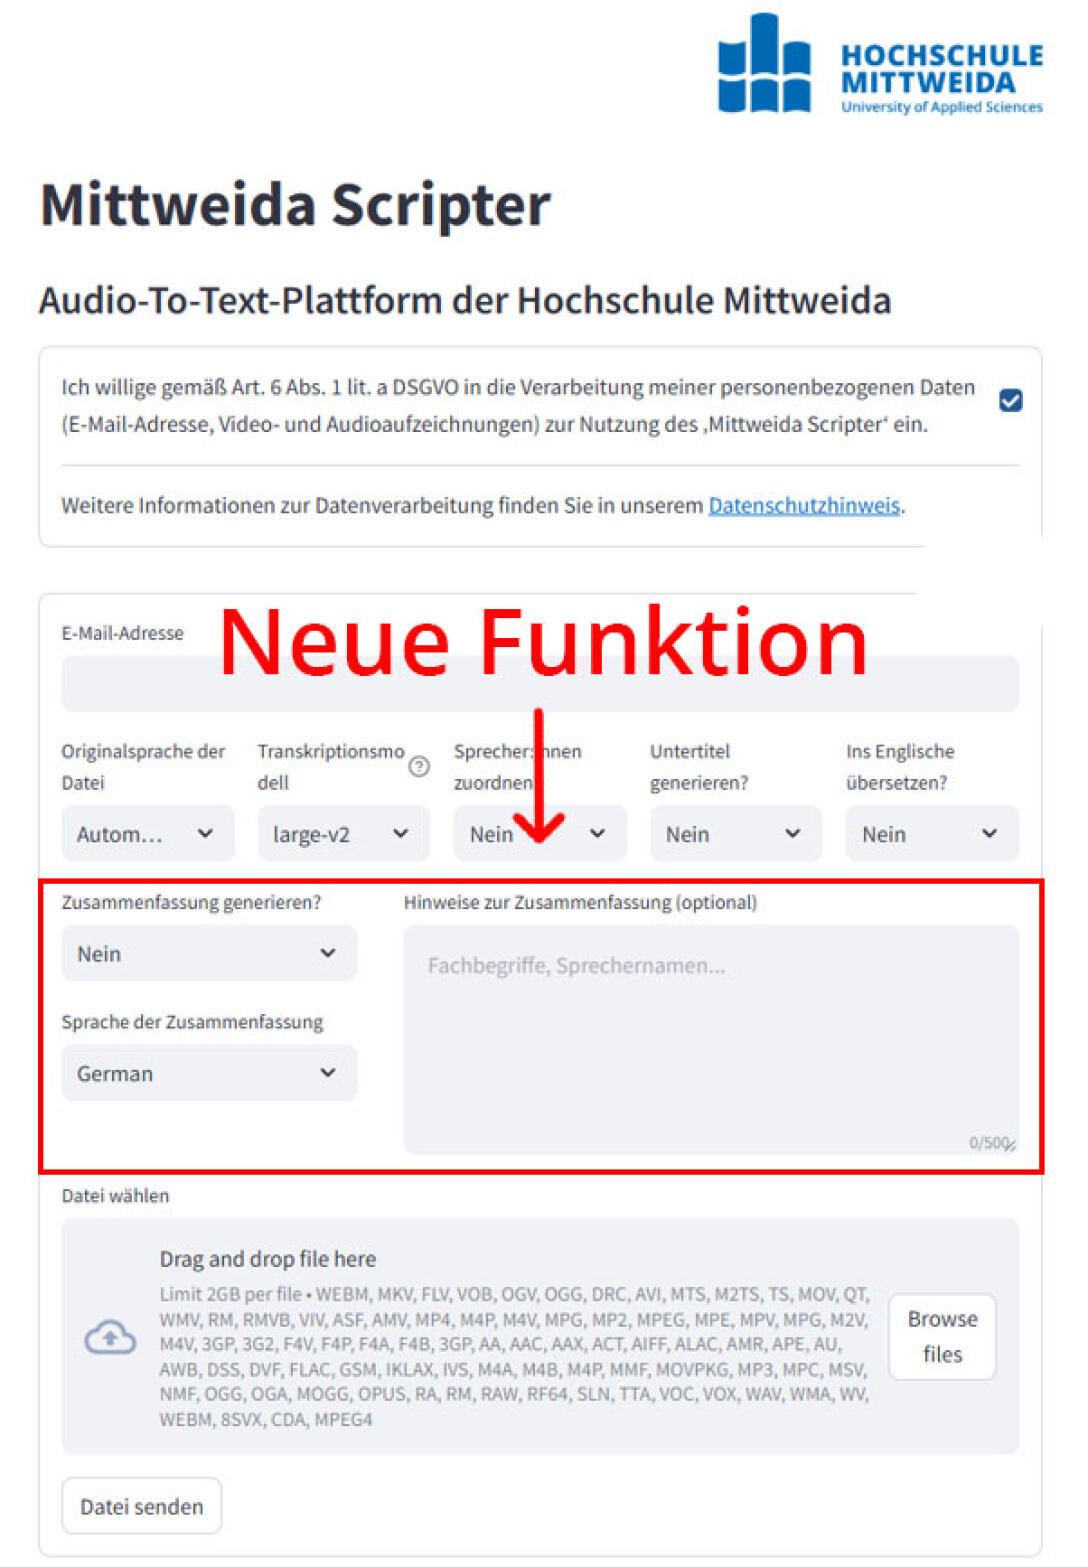
Neben der eigentlichen Transkription können Nutzerinnen und Nutzer nun direkt auswählen, ob zusätzlich eine KI-generierte Zusammenfassung erstellt werden soll. Dafür wurde ein Large Language Model in die Infrastruktur des Mittweida Scripters integriert, das auf eigenen Serverressourcen betrieben wird.
Der entscheidende Unterschied besteht darin, dass das erzeugte Transkript für die Zusammenfassung nicht zunächst heruntergeladen werden muss. Transkription und Zusammenfassung können innerhalb desselben Workflows erfolgen.
Auf der Webseite befindet sich dafür inzwischen die zusätzliche Option „Zusammenfassung generieren?“. Wird sie aktiviert, können weitere Einstellungen vorgenommen werden. Beispielsweise lässt sich die gewünschte Sprache der Zusammenfassung auswählen. Zusätzlich steht ein Textfeld zur Verfügung, über das der KI weitere Hinweise gegeben werden können.
So kann beispielsweise angegeben werden, dass bestimmte Themen besonders berücksichtigt, Fachbegriffe hervorgehoben oder am Ende noch einmal zentrale Aussagen zusammengetragen werden sollen.
Damit soll die Zusammenfassung nicht nur eine verkürzte Variante des Transkripts sein, sondern möglichst zu dem jeweiligen Anwendungsfall passen.
Was technisch dahintersteckt
An dieser Stelle wurde die Weiterentwicklung des Mittweida Scripters technisch deutlich anspruchsvoller. Denn ein Transkript einfach an ein Sprachmodell zu übergeben, funktioniert zwar bei kurzen Texten relativ problemlos. Bei langen Interviews entstehen jedoch schnell Textmengen, bei denen unter anderem Kontextlänge, Aufteilung des Transkripts, Länge der erzeugten Zusammenfassung und die Formulierung der Prompts eine wichtige Rolle spielen.
Mein Kollege Erik Herrmann hat sich intensiv mit der Integration und Optimierung dieser Funktion beschäftigt und beschreibt im folgenden Abschnitt, wie unsere aktuelle Lösung technisch aufgebaut ist.
Technischer Hintergrund
von Erik Herrmann
Am Anfang stand zunächst die Auswahl eines geeigneten Sprachmodells. Dafür haben wir verschiedene Modelle getestet, darunter beispielsweise gpt-oss und Llama. Die besten Ergebnisse lieferte dabei Gemma4:e4b, dass wir inzwischen über einen Ollama-Docker-Container betreiben.
Damit war allerdings erst die Grundlage geschaffen. Die eigentliche Frage lautete, wie sich ein langes Transkript so an das Modell übergeben lässt, dass möglichst keine Informationen verloren gehen.
In der ersten Version haben wir den Text dafür in feste Abschnitte unterteilt, sogenannte Chunks. Dabei zeigte sich jedoch schnell ein Problem: Weil der Text an festen Stellen hart abgeschnitten wurde, gingen teilweise Informationen verloren. Aus diesem Grund haben wir das Kontextfenster erhöht und nah an das Limit des Modells angepasst. Pro Aufruf kann das Modell dadurch deutlich mehr Informationen verarbeiten, wodurch sich der Informationsverlust verringert.
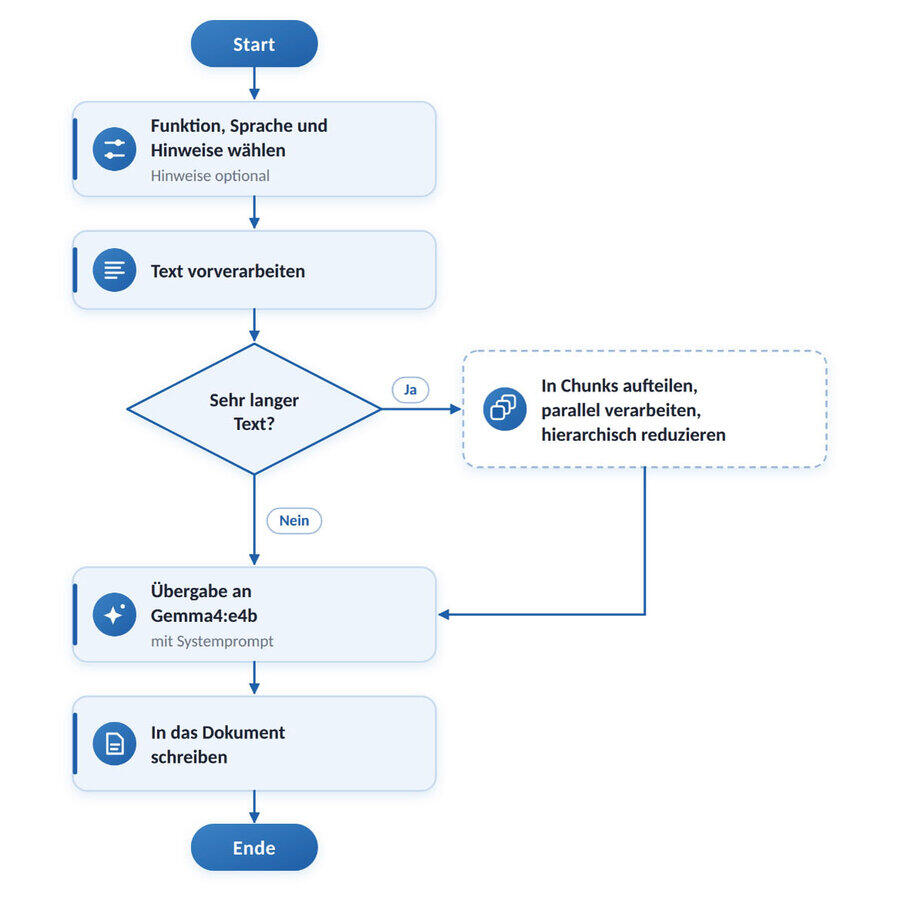
Ganz ohne Chunks kommen wir trotzdem nicht aus. Bei sehr langen Aufnahmen, die beispielsweise mehrere Stunden dauern, wird der Text weiterhin in solche Abschnitte unterteilt. Im Vergleich zur ersten Version ist jeder einzelne Chunk nun aber viel größer und enthält entsprechend mehr Informationen. In diesem Fall werden die Chunks zusätzlich in Gruppen eingeteilt und hierarchisch reduziert, um den Informationsverlust möglichst gering zu halten. Am Ende entsteht so wieder ein einzelner Text, der anschließend zusammen mit einem festgelegten Systemprompt an das Modell übergeben wird.
Auch dieser Systemprompt hat sich im Laufe der Entwicklung deutlich verändert. Anfangs war er sehr einfach gestaltet. Das führte dazu, dass in den Zusammenfassungen teilweise Markup-Fragmente wie „#" oder „*" enthalten waren. Zudem gab der Prompt lediglich eine maximale Wortzahl vor. Da der Text dabei auf eine feste Größe von 20 % reduziert wurde, entstanden teilweise sehr kurze Zusammenfassungen. In der zweiten Iteration haben wir den Systemprompt deshalb angepasst. Neben der ausgewählten Sprache enthält er nun auch eine Mindestanzahl an Wörtern sowie die Anweisung, wichtige Begriffe im Text hervorzuheben. Diese Begriffe werden im nächsten Schritt im Dokument fett gedruckt. Zusätzlich können dem Modell optional weitere Hinweise mitgegeben werden - beispielsweise, um einen bestimmten Schreibstil zu verwenden.
Neben der Zusammenfassung der Transkription wird auch die Zuordnung der Sprecherinnen und Sprecher zusammengefasst. Hierfür verwenden wir einen eigenen, speziell angepassten Systemprompt. Er soll sicherstellen, dass Aussagen direkt mit den vorhandenen Zeitstempeln und der sprechenden Person aus dem Originaldokument versehen werden.
Die größte Herausforderung lag rückblickend genau in der Gestaltung dieser Systemprompts. Denn bereits kleine Änderungen können das Ergebnis verändern. Eine wichtige Rolle spielt dabei vor allem die Konsistenz der Antworten, damit alle Nutzerinnen und Nutzer die gleiche Qualität erhalten.
Ebenso wenig sollte die Vorverarbeitung des Textes außer Acht gelassen werden. Hier muss eine Balance zwischen den verfügbaren Systemressourcen und der Antwortqualität gefunden werden. Dafür haben wir einen großen Testdurchlauf durchgeführt, um die zur Verfügung stehenden Ressourcen sinnvoll auszunutzen, ohne Systemabbrüche zu riskieren. Damit die Verarbeitung dennoch zügig abläuft, werden mehrere Chunks außerdem parallel verarbeitet. Nutzerinnen und Nutzer erhalten so wie gewohnt schnell ihr Ergebnis. In der nachfolgenden Abbildung wird der Ablauf der Zusammenfassung noch einmal dargestellt.
Ein kleiner Schritt im Interface – ein großer Schritt im Workflow
Auf den ersten Blick besteht die neue Funktion lediglich aus einigen zusätzlichen Auswahlfeldern auf der Webseite. Für den eigentlichen Arbeitsablauf macht sie jedoch einen erheblichen Unterschied.
Gerade bei Interviews und Gesprächsdaten, die personenbezogene oder vertrauliche Informationen enthalten, ist das für uns ein wichtiger Schritt. Denn Datenschutz sollte nicht nur einen einzelnen Verarbeitungsschritt betreffen. Entscheidend ist die gesamte Verarbeitungskette.
Gleichzeitig zeigt diese Weiterentwicklung sehr schön, wie sich ein zunächst relativ spezialisiertes Werkzeug nach und nach zu einer umfassenderen Anwendung entwickeln kann. Der Mittweida Scripter begann als Lösung für ein ganz konkretes Problem: Audio- und Videodateien möglichst einfach und innerhalb unserer eigenen Infrastruktur zu transkribieren. Seitdem kamen unter anderem Sprecherinnen- und Sprecherzuordnung, verschiedene Ausgabe- und Sprachoptionen und nun die automatisierte Zusammenfassung hinzu. Der ursprüngliche Beitrag über Mittweida Scripter beschrieb diese kontinuierliche Weiterentwicklung einmal sinngemäß wie das Bauen mit Lego – mit jedem zusätzlichen Baustein entstehen neue Möglichkeiten. Dieser Vergleich passt für mich nach wie vor sehr gut. Denn auch die neue Zusammenfassungsfunktion wird mit Sicherheit nicht der letzte Baustein des Mittweida Scripters sein.
Fazit
Mit der Integration eines lokal betriebenen Large Language Models erweitert sich der Mittweida Scripter von einem reinen Transkriptionswerkzeug zunehmend zu einem Werkzeug für eine viel umfassendere Verarbeitung von Audio- und Videoinhalten. Der für uns wichtigste Punkt dabei ist jedoch nicht allein die Nutzung generativer KI. Entscheidend ist vielmehr, wo und wie diese KI eingesetzt wird. Wenn wir Hochschulangehörigen Werkzeuge zur Verfügung stellen möchten, mit denen sie KI auch bei sensibleren Daten sinnvoll einsetzen können, müssen wir Alternativen zu einem Workflow schaffen, bei dem Inhalte für jeden einzelnen Verarbeitungsschritt an einen externen Dienst übertragen werden. Mit der neuen Zusammenfassungsfunktion versuchen wir, genau diese Lücke ein Stück weiter zu schließen.
Autoren